Nowe materiały Google dla SEO: ruch z wyszukiwarki, CDN i „things to do”
Między 9 a 12 listopada 2026 roku Google opublikował w Search Central trzy materiały ważne dla SEO. Pierwszy wyjaśnia, jak rozpoznać ruch z wyszukiwarki po nagłówku HTTP Referer. Drugi tłumaczy, dlaczego po przejściu na CDN rośnie aktywność Googlebota i jak nie zablokować go zabezpieczeniami. Trzeci rozszerza dokumentację modułów dla agregatorów i dostawców w Europejskim Obszarze Gospodarczym o zapytania „things to do”. Poniżej opisuję każdą zmianę i to, co oznacza w praktyce.
Jak rozpoznać ruch z wyszukiwarki Google?
Ruch z Google Search rozpoznaje się po nagłówku HTTP Referer, który przeglądarka wysyła po kliknięciu wyniku. Opisuje to nowa strona dokumentacji Google z 12 listopada 2026 roku.
Google stosuje politykę odsyłacza origin. Nagłówek zawiera więc tylko schemat i domenę, bez ścieżki i parametrów adresu. Z samego nagłówka nie da się odczytać zapytania użytkownika.
| Źródło kliknięcia | Wartość nagłówka Referer |
|---|---|
| Google Search w przeglądarce | https://www.google.com/ lub lokalna domena, np. https://www.google.pl/ |
| aplikacja Google na Androidzie | android-app://com.google.android.googlequicksearchbox/https/www.google.com lub domena Google |
| aplikacja Google na iOS | https://www.google.com/ lub lokalna domena Google |
Ruch z Discover ma te same wartości co powierzchnia, na której użytkownik go zobaczył. Tak samo oznaczony jest ruch z innych usług na tych domenach, np. z Grafiki Google.
Dokumentacja nie wyróżnia osobno ruchu z AI Overviews ani z trybu AI. Oznacza to, że nie da się go oddzielić od zwykłych kliknięć na podstawie samego nagłówka.
Nagłówek bywa też pusty. Dzieje się tak m.in. w trybie prywatnym, przy niektórych blokadach śledzenia, po otwarciu wyniku w nowej karcie w części przeglądarek i przy przejściu z widżetu wyszukiwania do przeglądarki.
Większość narzędzi analitycznych sama klasyfikuje taki ruch jako organiczny z Google. Gdy pojawia się jako odesłanie albo ruch bezpośredni, Google radzi sprawdzić własne reguły kanałów, wykluczenia odesłań i filtry. Czy tag GA4 na stronie wysyła poprawne dane, sprawdzi bezpłatny audyt GA4.
Dane z analityki zwykle nie zgadzają się 1:1 z kliknięciami w Google Search Console. Google wymienia cztery główne przyczyny:
- ustawienia prywatności, blokery reklam i brak zgody na śledzenie,
- przekierowania po stronie klienta, które zastępują Referer lub usuwają parametry, np. gclid,
- różne metody pomiaru: Search Console liczy kliknięcie, a analityka wizytę po załadowaniu strony,
- ruch płatny, którego Search Console nie uwzględnia.
Dlaczego po migracji na CDN rośnie aktywność Googlebota?
Po przejściu na CDN aktywność Googlebota rośnie, bo serwer odpowiada szybciej, a Google odbiera to jako sygnał, że może crawlować więcej. Wyjaśnia to wpis na blogu Google Search Central z 11 listopada 2026 roku, autorstwa Cherry Prommawin i Gary’ego Illyesa.
Google ustala tzw. limit wydajności crawlowania (crawl capacity limit) na podstawie kondycji serwera. Wolniejsze odpowiedzi obniżają tempo crawlowania. Szybkie i stabilne odpowiedzi stopniowo je podnoszą, o ile Google ma zapotrzebowanie na crawlowanie strony.
Na czym polega problem zimnego cache?
Nowy CDN startuje z pustym cache. Przy pierwszym żądaniu każdego adresu serwer brzegowy nie ma jego kopii i musi pobrać ją z serwera źródłowego. Dopiero kolejne żądania tego samego adresu obsługuje sam CDN.
Użytkownicy odwiedzają zwykle niewielką grupę popularnych stron, które szybko trafiają do cache. Roboty robią odwrotnie i systematycznie przechodzą przez wszystkie adresy w serwisie. Każdy nieobsłużony jeszcze adres trafia więc na serwer źródłowy.
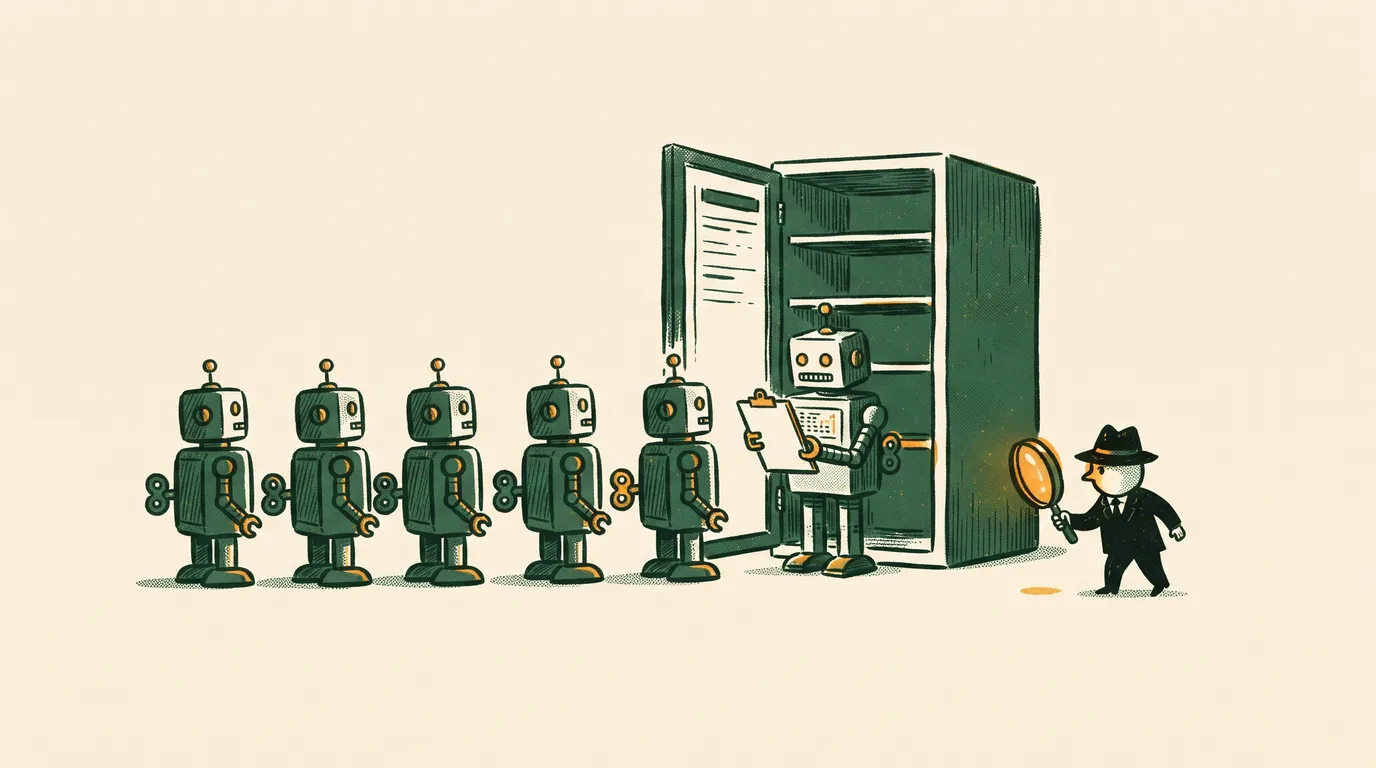
Google zaznacza, że roboty nie przyspieszają od razu, a wiele CDN-ów wygładza nagłe skoki ruchu. Mimo to do czasu rozgrzania cache główne obciążenie nadal ponosi serwer źródłowy.
Dlaczego nie warto blokować wszystkich botów?
Widząc skok ruchu automatycznego, administratorzy często włączają w CDN ogólną ochronę przed botami. Taka reguła bez wyjątków traktuje Googlebota jak każdego innego bota. Googlebot nie rozwiąże CAPTCHA, więc trafia na stronę z błędem.
Dla Google taka witryna wygląda na celowo zablokowaną lub uszkodzoną. Jeśli blokada zostanie na dłużej, roboty ograniczą crawlowanie, a strony i oferty produktowe zaczną znikać z wyników.
Jak bezpiecznie przejść na CDN?
Google proponuje trzy kroki:
- Dopuść zweryfikowane boty. Większość CDN-ów i zapór WAF ma gotową regułę dla znanych botów. Roboty Google można zweryfikować po opublikowanych zakresach adresów IP. Niechciane boty lepiej blokować punktowo, np. w robots.txt.
- Rozgrzej cache przed przełączeniem ruchu. Pobierz przez CDN najpopularniejsze strony, strony planowanych promocji i najczęściej crawlowane adresy, w kontrolowanym tempie.
- Użyj kodów 429 lub 503 jako awaryjnego hamulca. Jeśli serwer źródłowy nadal nie wytrzymuje, zwracaj przez krótki czas kod 429 lub 503. Google zaleca najwyżej kilka godzin, maksymalnie 1–2 dni.
Nie należy natomiast zostawiać robotom Google stron z błędem 403 ani wyzwań typu CAPTCHA. Temat wpisu Google omówił też w 5. odcinku serii wideo „The Non-Canonical Cabinet”.
Jak Google obsługuje zapytania „things to do” w EOG?
W Europejskim Obszarze Gospodarczym zapytania o atrakcje i aktywności, czyli „things to do”, mogą teraz uruchamiać moduły agregatorów i dostawców. Google dopisał tę kategorię do dokumentacji obu modułów 9 listopada 2026 roku.
| Moduł | Dla kogo | Jak działa | Jak dołączyć |
|---|---|---|---|
| moduł agregatorów (aggregator unit) | wyszukiwarki pionowe: biura podróży online, porównywarki, metawyszukiwarki, katalogi | pokazuje wyniki jednego agregatora, użytkownik może przełączyć się na innego | formularz Google Search Aggregator Features i plik danych |
| moduł dostawców (supplier unit) | bezpośredni dostawcy, np. atrakcje, hotele, firmy usługowe | pojawia się obok modułu agregatorów i tylko razem z nim | strona musi obsługiwać użytkowników z EOG i należeć do bezpośredniego dostawcy |
Oba moduły działają tylko dla użytkowników w EOG. Obejmują teraz zapytania o hotele, loty, pociągi i autobusy dalekobieżne, produkty, lokalne firmy oraz atrakcje i aktywności.
W module agregatorów domyślnie rozwinięte są wyniki najwyżej ocenionego dostawcy. Kliknięcie prowadzi na stronę agregatora. Dane dla zapytań „things to do” agregator przekazuje przez plik Local and things to do Point of Interest Feed.
Google zaleca w nim m.in. dokładne opisy, zdjęcia bez znaków wodnych, prawdziwe oceny oraz aktualne ceny i dostępność. Odradza pisanie nazw wielkimi literami, emoji i hasła promocyjne w nazwach.
Dla firm turystycznych w Polsce zmiana może oznaczać nową konkurencję o miejsce w wynikach. Portale z ofertami wycieczek i biletów mogą zgłosić się do modułu agregatorów, a same atrakcje do modułu dostawców.
Co warto zrobić po tych zmianach?
Z trzech materiałów Google wynika kilka konkretnych zadań dla zespołów SEO i administratorów:
- sprawdzić, czy ruch z Google nie trafia w analityce do odesłań lub ruchu bezpośredniego przez własne reguły kanałów,
- przy analizie logów serwera liczyć tylko żądania stron docelowych, a nie obrazów, CSS i skryptów,
- przed migracją na CDN rozgrzać cache dla najważniejszych i najczęściej crawlowanych adresów,
- w CDN i WAF dopuścić zweryfikowane boty, zamiast włączać blokadę wszystkich botów,
- po migracji obserwować statystyki indeksowania w Search Console,
- w branży turystycznej sprawdzić, czy firma może dołączyć do modułu agregatorów lub dostawców w EOG.
Najczęściej zadawane pytania
Q.Jak rozpoznać ruch z Google w logach serwera?
Ruch z Google rozpoznaje się po nagłówku Referer, który zawiera domenę Google, np. https://www.google.com/ lub https://www.google.pl/. Aplikacja Google na Androidzie może wysyłać wartość zaczynającą się od android-app://. W logach warto liczyć tylko żądania stron docelowych, bo zasoby strony mają w nagłówku własny adres witryny.
Q.Czy można rozpoznać ruch z AI Overviews i trybu AI?
Nowa dokumentacja Google nie opisuje osobnych wartości nagłówka dla AI Overviews ani trybu AI. Google wysyła tylko domenę, bez ścieżki i parametrów, więc sam nagłówek nie pozwala odróżnić tych kliknięć od zwykłych wyników. W analityce taki ruch będzie więc wyglądał jak zwykły ruch organiczny z Google.
Q.Dlaczego po włączeniu CDN Googlebot crawluje więcej?
CDN skraca czas odpowiedzi, a Google odbiera szybkie i stabilne odpowiedzi jako znak, że serwer może przyjąć więcej żądań. Nowy CDN ma jednak pusty cache. Dlatego każdy adres pobierany pierwszy raz trafia na serwer źródłowy. Do czasu rozgrzania cache to on ponosi główne obciążenie.
Q.Czym jest moduł agregatorów w Google?
Moduł agregatorów to element wyników Google w EOG, który pokazuje oferty jednej wyszukiwarki pionowej, np. biura podróży online czy porównywarki. Użytkownik może przełączyć się na innego agregatora. Od 9 listopada 2026 roku dokumentacja obejmuje też zapytania o atrakcje i aktywności, czyli „things to do”.
Na jakich źródłach opiera się artykuł?
Artykuł opiera się wyłącznie na materiałach Google Search Central:
- „Identify Google Search traffic in your web analytics or server logs”, zaktualizowana 12 listopada 2026 roku,
- „Moving to a CDN without overwhelming your origin (or blocking Googlebot)”, wpis na blogu z 11 listopada 2026 roku,
- „Aggregator unit in Google Search”, zaktualizowana 9 listopada 2026 roku,
- „Supplier unit in Google Search”, zaktualizowana 9 listopada 2026 roku.
Więcej w temacie: SEO i wyszukiwanie w AI
- Google AI Overview w praktyce: mechanizm, bramki decyzyjne i plan działania
- Jak zwiększyć widoczność marki w ChatGPT i Google AI Overview?
- Aktualizacja Google Lighthouse zmienia sposób symulowania ładowania przez PageSpeed Insights
- AI Search: jak działa wyszukiwanie AI
- Halucynacje sztucznej inteligencji: przyczyny i ochrona
- Powielona treść a cytaty w AI: co mówią patenty Google
- Ile kosztuje pozycjonowanie strony (SEO): widełki cenowe i czerwone flagi w ofertach
- Reklama w ChatGPT: co się zmienia w Polsce i czy da się ją już kupić
- GEO: czy Twoja marka zniknie z wyników, jeśli nie zoptymalizujesz się pod AI?
Po każdej migracji serwisu najpierw zagląda do statystyk indeksowania w Search Console i do reguł kanałów w analityce, a dopiero potem do pozycji.
LinkedInPodobne artykuły
Porozmawiajmy o Twoim wzroście
Wyślij brief lub zostaw kontakt. Odpowiemy w 24h.
Wyceń projekt