Powielona treść a cytaty w AI: co mówią patenty Google
Powielona treść ma szansę na cytat w odpowiedzi AI, ale głównie jako dowód dla konkretnego twierdzenia. Rzadziej trafia do zestawu jako nowe źródło. Patenty Google opisują dwa etapy, które oceniają powtórzenie odwrotnie. Przy doborze fragmentów do syntezy liczy się różnorodność, więc kopia już wybranej informacji prawdopodobnie traci miejsce. Przy weryfikacji i atrybucji ta sama informacja może wspierać konkretne zdanie odpowiedzi. Patenty opisują zakres ochrony prawnej i same nie potwierdzają, jak działają AI Overviews i AI Mode.
Czy powielona treść odpada już przy doborze fragmentów do odpowiedzi AI?
Powielona treść prawdopodobnie przegrywa przy doborze fragmentów, ale opisane rozwiązania nie przewidują za nią kary. Trzy patenty pokazują trzy różne miary powtórzenia: wobec zestawu, wobec korpusu i wobec historii użytkownika. Żadna z nich nie oznacza automatycznego wykluczenia strony.
Różnorodność zestawu źródeł
Patent US20260072965A1 opisuje długą odpowiedź budowaną z fragmentów najwyżej ocenianych zasobów. Fragmenty poniżej progu trafności odpadają. Następnie system iteracyjnie dodaje fragmenty najmniej podobne do już wybranych. Pulę uzupełniają fragmenty z dokumentów dla zapytań powiązanych.
Różnorodność jest tu kryterium całego zestawu. Pojedyncza strona nie dostaje w tym kroku własnej oceny. Ta sama strona może więc wejść do jednej odpowiedzi i nie wejść do innej. Decyduje to, co już wybrano. Fragment powtarzający wybraną już informację prawdopodobnie traci miejsce, ale nie dostaje kary. To hipoteza, bo patent jest w tym zestawieniu tylko tłem.
Łączenie podobnych fragmentów zamiast odrzucania
Patent US20090024606A1 wykrywa podobne fragmenty w korpusie za pomocą tabeli shingli, czyli nakładających się sekwencji słów. Podobne fragmenty są grupowane i rankingowane według jakości. Wynikiem jest interfejs z linkami między dokumentami. Powtórzenie służy tu więc do połączenia źródeł i żadne z nich nie znika. Patent nie mówi jednak, według jakich cech jedna kopia wygrywa z drugą.
Zysk informacyjny wobec tego, co użytkownik już widział
Patent US12326889B2 ocenia, ile nowych informacji dokument wnosi ponad treści wcześniej oglądane przez użytkownika. Wynik liczy model uczenia maszynowego. Ta sama strona może więc być nowa dla jednej osoby i zbędna dla innej. To inna miara niż wykrywanie kopii tekstu. Opis dotyczy jednak dokumentów pokazywanych użytkownikowi. O zestawie przekazywanym do syntezy patent nie mówi.
Czy deduplikacja wyników wyszukiwania dotyczy też odpowiedzi AI?
Deduplikacja z klasycznej wyszukiwarki i z wyszukiwarki zakupowej nie dotyczy wprost odpowiedzi AI. Dwa starsze patenty pokazują jedynie, jak system wybiera jeden wynik spośród niemal identycznych kopii. Służą tu jako analogia, nie dowód.
Patent US10007731B2, zgłoszony w 2012 roku, dotyczy klasycznej strony wyników. Gdy dwa wyniki prowadzą do tego samego zasobu docelowego, system zastępuje je jednym wynikiem zastępczym. Strona wyników pomija wtedy przynajmniej jeden z pierwotnych adresów.
Patent US20160232591A1 dotyczy wyszukiwarki zakupowej, w której wpisy opisują produkty. System liczy odległość między parą wpisów w przestrzeni wektorowej atrybutów. Na tej podstawie filtruje listę wyników, aby ograniczyć niemal identyczne wpisy tego samego sprzedawcy.
Przeniesienie tej logiki na AI Mode dałoby prostą konsekwencję. Z kilku adresów z tą samą treścią zostawałby jeden. Kilka prawie identycznych fragmentów jednego wydawcy konkurowałoby o jedno miejsce. Żaden z analizowanych raportów nie opisuje jednak takiego działania dla AI Overviews ani AI Mode.
Ryzyko dotyczy przede wszystkim serwisów, które rozbijają jeden temat na wiele bliźniaczych podstron. Typowy przykład to strony usług powielone dla kilku miast z podmienioną nazwą miejscowości. Konsolidacja takich podstron to rozsądna hipoteza do sprawdzenia na własnych danych. Nie jest to wymóg wynikający z opisu odpowiedzi AI.
Analogia ma też drugą stronę. Wyszukiwarka zakupowa ogranicza kopie w obrębie jednego sprzedawcy. Kopii między różnymi sprzedawcami ten filtr nie obejmuje. Jeśli podobna zasada działa w AI, konkurencja o miejsce dotyczy głównie własnych duplikatów wydawcy. Cudza kopia to osobny problem. Materiał go nie opisuje.
Jak ta sama informacja pomaga przy weryfikacji odpowiedzi AI?
Przy weryfikacji strona powtarzająca fakt z odpowiedzi staje się kandydatem na dowód, a nie konkurentem do odrzucenia. Trzy patenty dotyczące odpowiedzi AI opisują sprawdzanie twierdzeń przez wyszukiwanie dokumentów, które je wspierają. Kierunek oceny jest tu odwrotny niż przy doborze zestawu. Zgodność pomaga.
Wyszukiwanie dowodu dla faktu z odpowiedzi
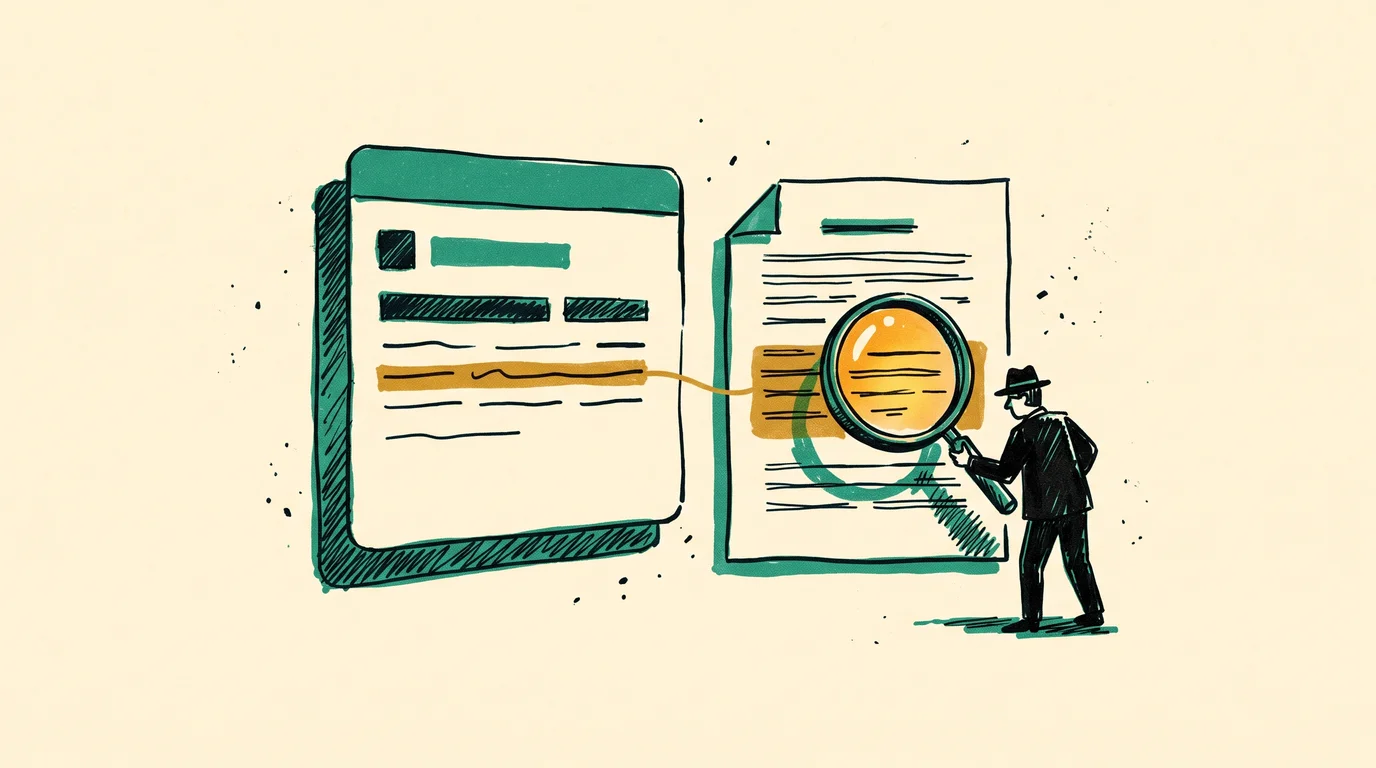
Patent US20240289395A1 opisuje model językowy z częścią generującą zapytanie i częścią generującą odpowiedź. Wygenerowane zapytanie trafia do wyszukiwarki, która zwraca zasoby wspierające. Jedno z roszczeń przewiduje wykrycie faktu we fragmencie odpowiedzi. Fragment staje się wtedy drugim zapytaniem. Odpowiedź otrzymuje element prowadzący do najwyżej ocenionego wyniku dla tego zapytania.
Analiza wynikania i korekta halucynacji
Patent US20250094456A1 opisuje analizę wynikania, czyli sprawdzenie, czy dokument logicznie potwierdza zdanie. System wyodrębnia fragmenty z wyjścia modelu i wybiera te, które nadają się do sprawdzenia. Dla każdego formułuje zapytanie i pobiera dokument. Model wynikania ocenia, czy dokument wspiera fragment, czy mu przeczy. Przy odpowiedzi pojawiają się adnotacje z tymi ocenami.
Patent US20260154578A1 stosuje ten sam schemat do korekty. Po ocenie wynikania wskazuje, którą część wyjścia trzeba przepisać. Opisy nie mówią jednak, czy strona użyta do weryfikacji jest potem pokazywana jako źródło.
Zgodność wielu dokumentów jako tło
Patent US8954412B1 ze zgłoszenia z 2006 roku opisuje korroborację faktów. System tworzy hipotetyczne odpowiedzi i liczy dokumenty, które wspierają każdą z nich. Za prawdopodobnie poprawny uznaje fakt z wymaganą liczbą dokumentów wspierających. W tym tle powtórzenie konsensusu działa na korzyść faktu. Raport nie rozstrzyga jednak, czy kopie jednego oryginału liczą się osobno. To najsłabszy punkt tej przesłanki.
Od czego zależy, czy AI zacytuje konkretny fragment strony?
Cytat prawdopodobnie zależy od tego, czy fragment strony wspiera konkretne zdanie odpowiedzi. Tematyczna zgodność całej strony ma mniejsze znaczenie. Dwa patenty opisują atrybucję jako parę: stwierdzenie i fragment dowodowy.
Patent CN120051770A opisuje pobieranie źródeł dowodowych dla tekstu pierwszego modelu językowego. Drugi model generuje nowy tekst po porównaniu pierwszego tekstu ze źródłami. Fragmenty źródeł zostają powiązane z tekstem jako atrybucja. Celem jest ustalenie, czy dana część treści jest wspierana przez zewnętrzny dowód, czy z nim sprzeczna.
Patent US20250156456A1 opisuje odpowiedź złożoną z jednego lub więcej stwierdzeń. Cytaty łączą każde stwierdzenie z fragmentem dowodowym w korpusie. Model oceny atrybucji mierzy jakość ugruntowania odpowiedzi. Model językowy jest dostrajany tak, żeby spełniał próg tej jakości.
Z obu opisów wynika, że jednostką cytowania jest akapit. Strona jest tylko opakowaniem. Akapit, który samodzielnie wspiera jedno twierdzenie, łatwiej dopasować do zdania odpowiedzi. Akapit wielowątkowy wymaga od systemu wyodrębnienia właściwej części. To ten sam powód, dla którego pozycja w Google i cytowanie przez AI potrafią się rozjechać, o czym piszemy w artykule GEO: czy Twoja marka zniknie z wyników.
Raporty nie opisują jednak kryterium wyboru między kilkoma stronami, które równie dobrze wspierają to samo stwierdzenie. Tu kończy się materiał dowodowy. Wszystko dalej to wnioskowanie.
Zestawienie obu etapów daje dwie drogi do odpowiedzi. Pierwsza nagradza inność fragmentu wobec zestawu, czyli nowy aspekt i własne dane. Druga nagradza zgodność z konkretnym twierdzeniem, czyli jasno podany ustalony fakt. Strona powtarzająca konsensus ma szansę głównie w tej drugiej drodze.
| Etap | Co ocenia system | Jak działa powtórzenie | Patenty |
|---|---|---|---|
| Dobór fragmentów do syntezy | Trafność i różnorodność zestawu | Kopia wybranej informacji prawdopodobnie traci miejsce | US20260072965A1, US20090024606A1, US12326889B2 |
| Weryfikacja i atrybucja | Czy dokument wspiera konkretne zdanie | Ta sama informacja może posłużyć jako dowód | US20240289395A1, US20250094456A1, US20260154578A1, CN120051770A, US20250156456A1 |
| Tło: deduplikacja i korroboracja | Kopie w wynikach, liczba dokumentów wspierających fakt | Analogia z innych dziedzin, bez potwierdzenia dla AI | US10007731B2, US20160232591A1, US8954412B1 |
Czego patenty nie mówią o powielonej treści?
Analizowane patenty nie opisują limitu fragmentów z jednej domeny ani kary za kopię treści. To dwa najczęstsze założenia w dyskusjach o powieleniu, a materiał nie daje dla nich podstawy.
Żadne przytoczone roszczenie nie opisuje limitu liczby fragmentów z jednej domeny ani z jednego zasobu w zestawie do syntezy. Tabela cech w jednym z raportów przypisuje wprawdzie roszczeniu wykluczanie wielu fragmentów z tej samej domeny. Przytoczony tekst roszczeń tego jednak nie zawiera. Taki limit pozostaje więc niepotwierdzony.
Materiał nie opisuje też wykrywania treści syndykowanej przy liczeniu dokumentów wspierających fakt. Nie wyjaśnia, jak system rozstrzyga sytuację, w której jedne źródła wspierają fragment, a inne mu przeczą. Patenty o przekierowaniach i ofertach sprzedawców są wyłącznie analogią z innych dziedzin.
Najmocniejszy kontrargument wobec tezy o wzmacnianiu faktu przez powtórzenie dotyczy zasięgu weryfikacji. Weryfikacja może sięgać tylko po najwyżej oceniony dokument dla zapytania utworzonego z fragmentu. Druga strona z tą samą treścią nie zostałaby wtedy w ogóle pobrana. Materiał nie rozstrzyga tej hipotezy w żadną stronę.
Wszystkie omawiane dokumenty opisują zakres ochrony prawnej. Zgłoszenie patentowe nie dowodzi, że Google stosuje dany mechanizm w AI Overviews i AI Mode. Nie mówi też, z jaką wagą opisane rozwiązanie działałoby obok innych sygnałów rankingowych. Patent to możliwość, nie wdrożenie.
Wnioski z tej analizy to zatem hipotezy robocze. Każdą z nich da się sprawdzić na własnych danych, obserwując, które akapity pojawiają się jako źródło.
Co zrobić z treścią, która powtarza ustalone fakty?
Treść powtarzającą ustalone fakty warto rozdzielić na dwie warstwy: akapity z faktami do weryfikacji i akapity z nowym aspektem do zestawu. Każda warstwa celuje w inny etap opisany w patentach. Poniższe kroki są interpretacją, nie twierdzeniem patentowym.
Diagnoza zaczyna się od zapytań. Pierwszym krokiem jest wybór 10–20 zapytań, dla których strona ma być źródłem. Dla każdego zapisuje się aspekty, które pokrywają już cytowane strony. Dobór według różnorodności wymaga wiedzy, czym własny fragment różni się od wybranych.
Drugi krok dotyczy twierdzeń. Dla każdej strony, która ma być źródłem, powstaje lista 3–5 twierdzeń, a każde dostaje akapit, który je samodzielnie wspiera. Atrybucja w opisanych mechanizmach łączy stwierdzenie z konkretnym fragmentem strony.
Trzeci krok to kontrola powtórzeń, czyli sprawdzenie, czy te same akapity występują na innych podstronach serwisu albo u partnerów. Opis z patentu o shinglach pokazuje, że powtórzenie da się wykryć na poziomie sekwencji słów.
Warstwa faktów wymaga prostoty. Ustalony fakt najlepiej podać jednym jasnym zdaniem, spójnym z niezależnymi źródłami. Analiza wynikania ocenia, czy dokument wspiera konkretny fragment, więc zdanie musi dać się zestawić z jednym twierdzeniem.
Warstwa nowości wymaga własnego wkładu: własnych danych albo aspektu, którego brakuje cytowanym stronom. Pomagają też odpowiedzi na pytania uzupełniające, które użytkownik zada po podstawowej odpowiedzi.
Pomiar zamyka cykl. Co około 30 dni sprawdza się dla wybranych zapytań, które akapity pojawiają się jako źródło. Akapity z faktami i akapity z własnymi danymi trzeba śledzić osobno, bo opisane ścieżki nagradzają co innego. Czy cytaty przekładają się na wejścia na stronę, pokaże GA4, o ile pomiar działa poprawnie. To sprawdzisz w Audycie GA4.
Błędem jest parafrazowanie już cytowanego źródła bez nowego aspektu. Przy doborze według różnorodności taki fragment przegrywa z oryginałem, który już jest w zestawie. Drugim błędem jest rozmywanie twierdzeń w długich, wielowątkowych akapitach. Tak pracujemy z treściami klientów w ramach usługi SEO i GEO.
Q.Czy Google karze za powieloną treść w AI Overviews?
Analizowane patenty nie opisują kary za powieloną treść w odpowiedziach AI. Opisany dobór fragmentów premiuje różnorodność zestawu, więc kopia prawdopodobnie traci miejsce, ale nie jest karana. Przy weryfikacji ta sama informacja może nawet pełnić rolę dowodu. Patenty nie potwierdzają jednak działania AI Overviews.
Q.Czy kopie mojego tekstu u partnerów wzmocnią fakt w odpowiedzi AI?
Nie wiadomo, bo materiał tego nie rozstrzyga. Patent US8954412B1 liczy dokumenty wspierające fakt, ale nie opisuje traktowania kopii jednego oryginału. Mogą liczyć się jako kilka dokumentów albo jako jeden. Bezpieczniej nie zakładać, że syndykacja tekstu wzmocni jego pozycję w odpowiedziach AI.
Q.Czy kilka podobnych podstron może trafić do jednej odpowiedzi AI?
Materiał tego nie wyklucza, ale analogie z deduplikacji sugerują ryzyko. Patent o wyszukiwarce zakupowej ogranicza niemal identyczne wpisy tego samego sprzedawcy. Gdyby podobna logika działała w AI, bliźniacze podstrony konkurowałyby o jedno miejsce. Żaden raport nie opisuje jednak takiego mechanizmu dla odpowiedzi AI.
Q.Czy przepisanie cudzego tekstu własnymi słowami wystarczy do cytatu w AI?
Prawdopodobnie nie, jeśli parafraza nie wnosi nowego aspektu. Dobór fragmentów według patentu US20260072965A1 dodaje fragmenty najmniej podobne do już wybranych. Parafraza tej samej informacji przegrywa wtedy z oryginałem. Szansę daje jasne podanie faktu w roli dowodu albo dopisanie własnych danych.
Więcej w temacie: SEO i wyszukiwanie w AI
- Ile kosztuje pozycjonowanie strony (SEO): widełki cenowe i czerwone flagi w ofertach
- Reklama w ChatGPT: co się zmienia w Polsce i czy da się ją już kupić
- GEO: czy Twoja marka zniknie z wyników, jeśli nie zoptymalizujesz się pod AI?
Śledzi, jak wyszukiwarki z AI dobierają źródła do odpowiedzi, i porządkuje treści serwisów tak, żeby pojedyncze akapity dało się zacytować.
LinkedInPodobne artykuły
Porozmawiajmy o Twoim wzroście
Wyślij brief lub zostaw kontakt. Odpowiemy w 24h.
Wyceń projekt