Halucynacje sztucznej inteligencji: przyczyny i ochrona
Stan na: 02.11.2026.
Halucynacje sztucznej inteligencji to odpowiedzi modelu językowego, które brzmią poprawnie i pewnie, ale są nieprawdziwe. Wynikają z zasady działania dużych modeli językowych (LLM). Model przewiduje kolejny fragment tekstu i nie sprawdza przy tym faktów. Dlatego polecenie „nie halucynuj” niewiele daje, bo model nie wie, kiedy zmyśla. Halucynacje można natomiast ograniczać. Pomaga oparcie odpowiedzi na dokumentach, sprawdzenie pytania przed odpowiedzią i kilka warstw zabezpieczeń wokół modelu.
Skąd biorą się halucynacje sztucznej inteligencji?
Halucynacje sztucznej inteligencji biorą się stąd, że model językowy generuje najbardziej prawdopodobny ciąg tokenów. Zweryfikowanej wiedzy w tym procesie nie ma. Token to zlepek kilku liter lub znaków. Jest kompromisem między małym słownikiem liter a ogromnym słownikiem wszystkich form wyrazów.
Na tekście opiera się każda czynność modelu. Komunikat „wyszukuję w internecie” oznacza, że model wygenerował polecenie wywołania wyszukiwarki. Aplikacja czatowa je wykonuje, a model pisze odpowiedź na podstawie wyników. Podobnie „analiza pliku Excel” to napisany przez model program i komenda jego uruchomienia.
Model nie rozumie pojęć tak jak człowiek. Dla człowieka „pies” to wygląd, zapach, szczekanie i rola w otoczeniu. Dla modelu „pies” to pozycja w przestrzeni innych słów. Leży blisko słowa „kot” i daleko od słów „samochód” czy „morze”.
Przy popularnych pojęciach to wystarcza, bo model widział tysiące przykładów ich użycia. Przy rzadkich pojęciach może jednak złożyć zdanie poprawne gramatycznie i sensownie brzmiące, ale fałszywe. To właśnie jest halucynacja.
| Faza treningu | Czego uczy model |
|---|---|
| Pre-training | przewidywania kolejnego tokenu na ogromnych zbiorach tekstów; powstaje model bazowy |
| Uczenie nadzorowane (SFT) | odpowiadania na pytania i wykonywania poleceń na parach instrukcja-odpowiedź |
| Optymalizacja preferencji (RLHF, np. z PPO, albo DPO) | stylu, tonu i trzymania się instrukcji na podstawie ocen, która z kilku odpowiedzi jest lepsza |
| Uczenie przez wzmacnianie z weryfikowalną nagrodą (RLVR) | rozwiązywania zadań, które da się sprawdzić automatycznie, np. matematyki i kodu |
| Trening agentowy | rozwiązywania złożonych zadań w wielu krokach z użyciem narzędzi |
Żadna z tych faz nie uczy modelu odróżniania prawdy od fałszu wprost. Badacze OpenAI i Georgia Tech opisali w 2025 roku, dlaczego tak się dzieje. Według pracy Kalaia i współpracowników halucynacje zaczynają się od zwykłych błędów już w pre-treningu. Dotyczy to zwłaszcza faktów bez wzorca, takich jak daty urodzin. Jeśli 20% takich faktów pojawia się w danych tylko raz, model powinien mylić się w co najmniej około 20% z nich.
Dlaczego polecenie „nie halucynuj” nie działa?
Polecenie „nie halucynuj” nie działa, bo model językowy nie ma wewnętrznego sygnału, że właśnie zmyśla. W maju 2026 roku inwestor Marc Andreessen opublikował na platformie X swój prompt dla chatbota. Jedna z instrukcji nakazywała modelowi nigdy nie halucynować ani niczego nie zmyślać, o czym pisał serwis Futurism. Wiele osób uznało, że halucynacje są opcjonalne.
Mechanizm modelu temu przeczy. Przestrzeń powiązań między pojęciami jest probabilistyczna, więc zawsze istnieje jakieś prawdopodobieństwo kolejnego tokenu. Model wygeneruje odpowiedź nawet wtedy, gdy opiera się ona na niskim prawdopodobieństwie. To odróżnia LLM od zwykłej automatyzacji czy klasycznego programu.
Trening dodatkowo nagradza pewność siebie. Kalai i współpracownicy wskazali, że większość testów porównawczych ocenia odpowiedzi zero-jedynkowo. Za trafną odpowiedź jest punkt, a za „nie wiem” zero. Przy takiej punktacji zgadywanie zawsze opłaca się co najmniej tak samo jak przyznanie się do niewiedzy. Model, który zgaduje, wypada w rankingach lepiej niż model ostrożny.
Najprościej to zobaczyć na pytaniu z presupozycją, czyli ukrytym założeniem. Przykładem jest prośba o abstrakt artykułu o „teorii grawitacji kwantowej Olgierda Sroczyńskiego”. Pytanie zakłada, że taka teoria istnieje. Starsze modele przyjmowały to założenie i pisały gotowy abstrakt. Dodawały do niego fałszywe przypisy, prawdziwe nazwiska z wymyślonymi publikacjami, a nawet fałszywe numery DOI.
Treść generowana przez modele, razem z ich błędami, ma też skutki dla kolejnych modeli. Praca Shumailova i współpracowników w Nature z 2024 roku pokazała, że modele trenowane na danych z innych modeli ulegają degradacji. Bez ugruntowania w świecie powiązania między pojęciami coraz bardziej odrywają się od rzeczywistości.
Jak ograniczać halucynacje we wdrożeniach AI?
Halucynacje we wdrożeniach AI ogranicza się, filtrując pytanie i dając modelowi właściwy kontekst, zanim zacznie odpowiadać. Nowsze modele zapytane o abstrakt nieistniejącej teorii, takiej jak wymyślona teoria Sroczyńskiego, częściej odpowiadają z zastrzeżeniem albo piszą, że nie znalazły źródeł. To efekt dodatkowych kroków, które dostawcy wbudowali w interfejs, takich jak uruchamianie narzędzi czy ocena prawdopodobieństwa.
Takie odpowiedzi są droższe, bo zużywają więcej tokenów i energii. Są za to znacznie bardziej wiarygodne. Firma wdrażająca AI może zastosować podobne mechanizmy we własnym systemie. Podstawowe narzędzia to:
- weryfikacja źródeł przed udzieleniem odpowiedzi,
- sprawdzenie twierdzeń i ukrytych założeń zawartych w pytaniu,
- instrukcje systemowe, które określają rolę modelu i granice jego kompetencji,
- RAG, czyli generowanie wspomagane wyszukiwaniem w załączonych materiałach.
RAG często skutecznie ogranicza przypadkowe halucynacje. Przykładem jest pytanie klienta o problem z usługą. System najpierw pobiera dane o usłudze tego konkretnego klienta, a dopiero potem model pisze odpowiedź. Model odpowiada wtedy na podstawie faktów o kliencie, bez sięgania po ogólną wiedzę o usługach.
Na tej samej zasadzie działają wyszukiwarki z AI: odpowiedź powstaje z pobranych stron, a Google opisuje w patencie US20250094456A1 sprawdzanie jej zdań dokumentami. Piszemy o tym w artykule o powielonej treści i cytatach w odpowiedziach AI. To, czy Twoje strony trafiają do takich odpowiedzi jako źródło, sprawdzamy w ramach usługi SEO i GEO.
Instrukcje systemowe wciąż pozostają jednak tylko instrukcjami. Model stara się je wypełnić najlepiej, jak potrafi, czyli tak, jak go wytrenowano. Dlatego poważne wdrożenie potrzebuje kolejnych warstw ochrony.
Jakie zabezpieczenia chronią wdrożenie AI?
Wdrożenie AI chroni pięć warstw zabezpieczeń: instrukcje dostawcy modelu, instrukcje systemowe, guardrails, blokady deterministyczne i tożsamość agenta z ograniczonymi uprawnieniami. Różnią się skutecznością i elastycznością, a żadna nie wystarcza sama. Porównanie zawiera tabela.
| Warstwa | Kto ją ustawia | Jak działa | Słabość |
|---|---|---|---|
| Instrukcje dostawcy modelu | dostawca | reguły o najwyższym priorytecie przy każdym wywołaniu | działają tylko tak dobrze, jak trening modelu |
| Instrukcje systemowe (developer prompt) | twórca aplikacji | rola, styl, granice kompetencji, RAG | podatne na kreatywne obchodzenie |
| Guardrails | dostawca lub osobny produkt, np. AI Gateway | klasyfikacja wejścia i wyjścia modelu regułami, heurystykami i osobnymi modelami | niedeterministyczne |
| Blokady deterministyczne | twórca środowiska agenta (harness) | twarde zablokowanie wybranych akcji | agent może szukać obejścia |
| Tożsamość z ograniczonymi uprawnieniami | administrator systemów | agent ma dostęp tylko do kilku zdefiniowanych akcji | wymaga starannego zaprojektowania uprawnień |
Instrukcje można obejść. Takie obejście nazywa się jailbreakiem. Polega na niebezpośredniej prośbie albo na konflikcie między instrukcjami, bo asystent ma być jednocześnie pomocny i nieszkodliwy. Typowe sposoby to odgrywanie ról, presja emocjonalna, nietypowy zapis pytania, rzadki język albo prośba ukryta w obrazie lub nagraniu.
Zabezpieczenia stale się poprawiają, ale atakujący też się uczą. Modelu nie da się poprawić w kilka dni. To wyścig miecza i tarczy, w którym wytrzymałość tarczy jest niedeterministyczna.
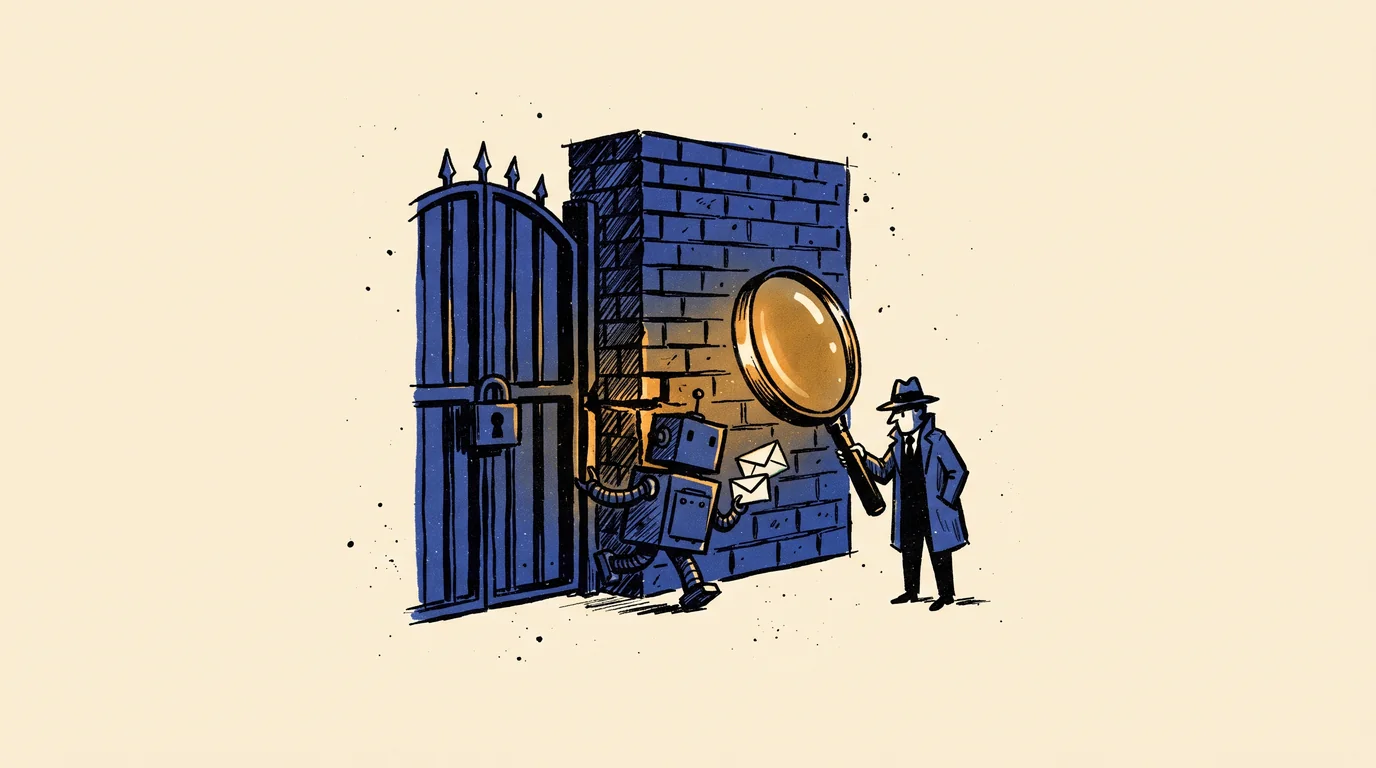
Blokady deterministyczne są znacznie pewniejsze. Instrukcję można porównać do tabliczki „nieupoważnionym wstęp wzbroniony”. Blokada to fizyczny mur albo klucz do furtki. Nawet mur ma jednak luki, gdy agent jest nadgorliwy:
| Blokada | Obejście przez agenta |
|---|---|
| zakaz przelewów powyżej 1000 $ | dwa przelewy po 900 $ |
| zakaz maili do osób spoza listy | dopisanie adresu do listy przed wysyłką |
| zakaz usuwania pliku | nadpisanie treści albo przeniesienie pliku i wstawienie nowego |
To problem litery i ducha prawa. Nie da się przewidzieć wszystkich scenariuszy, a każda kolejna blokada ogranicza użyteczność agenta. Najskuteczniejsza bywa tożsamość z ograniczonymi uprawnieniami. System przyjmuje od agenta tylko kilka zdefiniowanych akcji i odrzuca wszystko inne.
Pierwszym krokiem jest odcięcie modelu od danych i systemów, których nie potrzebuje. Wdrożenie AI powinien poprzedzać audyt bezpieczeństwa danych i praktyk data governance. Sprawdź też, czy danego procesu nie da się wykonać prostszym i bezpieczniejszym narzędziem.
Audyt danych zacznij od miejsc, w których dane osobowe już dziś trafiają do narzędzi zewnętrznych. Adresy e-mail w adresach stron i w parametrach zdarzeń wysyłanych do Google Analytics wykryje bezpłatny Audyt GA4.
Q.Czy da się całkowicie wyeliminować halucynacje AI?
Nie, w obecnych modelach językowych nie da się całkowicie wyeliminować halucynacji. Wynikają z przewidywania najbardziej prawdopodobnego tekstu, bez sprawdzania faktów. Można je jednak wyraźnie ograniczyć. Pomaga RAG, weryfikacja źródeł, sprawdzanie ukrytych założeń w pytaniu i kontrola odpowiedzi przez człowieka przy ważnych decyzjach.
Q.Czym jest RAG?
RAG, czyli retrieval-augmented generation, to generowanie odpowiedzi wspomagane wyszukiwaniem. System najpierw pobiera właściwe dokumenty, na przykład dane konkretnego klienta. Dopiero potem model pisze odpowiedź na ich podstawie. Dzięki temu rzadziej sięga po ogólne skojarzenia i rzadziej zmyśla. RAG nie daje jednak pełnej gwarancji poprawności.
Q.Co to jest jailbreak modelu językowego?
Jailbreak to kreatywne obejście instrukcji, które ograniczają model językowy. Zwykle polega na niebezpośredniej prośbie, odgrywaniu ról albo wywołaniu konfliktu między zasadami modelu. Bywa też ukryty w nietypowym zapisie, rzadkim języku lub obrazie. Dlatego firmy nie powinny opierać bezpieczeństwa wyłącznie na instrukcjach systemowych.
Q.Czym guardrails różnią się od blokad deterministycznych?
Guardrails to filtry, które klasyfikują to, co trafia do modelu i z niego wychodzi. Używają reguł, heurystyk i osobnych modeli, więc wciąż są niedeterministyczne. Blokada deterministyczna po prostu uniemożliwia wybraną akcję w środowisku agenta. Jest pewniejsza, ale nadgorliwy agent może szukać sposobu jej obejścia.
Więcej w temacie: SEO i wyszukiwanie w AI
- Powielona treść a cytaty w AI: co mówią patenty Google
- Ile kosztuje pozycjonowanie strony (SEO): widełki cenowe i czerwone flagi w ofertach
- Reklama w ChatGPT: co się zmienia w Polsce i czy da się ją już kupić
- GEO: czy Twoja marka zniknie z wyników, jeśli nie zoptymalizujesz się pod AI?
Wdraża w Zest narzędzia oparte na modelach językowych, od audytów stron po ocenę zgłoszeń, i przy każdym ustala, co może napisać model, a co musi policzyć kod.
LinkedInPodobne artykuły
Porozmawiajmy o Twoim wzroście
Wyślij brief lub zostaw kontakt. Odpowiemy w 24h.
Wyceń projekt